
过去,我们常见的 AI 服务器往往会是一台 4U 或 8U 机箱里安装 8 张 GPU。随着模型规模持续扩大,当一台8卡服务器已经无法容纳整个模型时,就需要通过张量并行、流水线并行等方式,把模型进一步拆分到多台GPU服务器上,再使用InfiniBand等高速网络完成节点间通信。
单台服务器内部GPU通信很快,但一旦跨服务器,就要经过网卡和交换机,速度马上就慢了。对于普通计算任务,这种模式没有太大问题。但对于超大模型,情况完全不同。模型可能被拆分到几十张 GPU 上,每一次计算都伴随着大量参数、激活值、梯度或者 Token 数据交换。GPU算得再快,如果大量时间都在“等数据”,最终整个系统的效率还是会下降。所以真正限制 AI 性能的已经不仅仅是“单张 GPU 有多快”,还有另一个越来越关键的问题: 几十甚至上百张 GPU 之间,能不能足够快地交换数据?
这就是今天要介绍的服务器——NVIDIA GB300 NVL72所解决的问题,它把整个机柜变成一台计算机。同时也代表着AI基础设施的一次架构变化:服务器的边界正在消失,整个机柜正在成为新的计算单元。
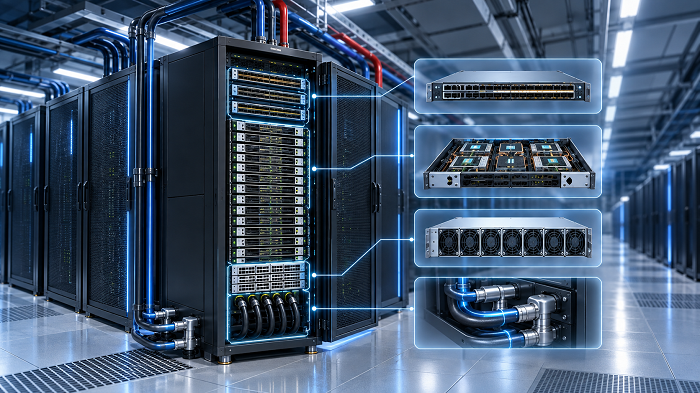
简而言之,一整柜的 NVIDIA GB300 NVL72 超级计算系统。它不是传统意义上“1台服务器里插72张GPU”,而是把18台计算托盘 + 9台 NVLink 交换托盘 + 电源系统 + 液冷系统集成到一个机柜里,让 72张 B300 GPU 组成一个超大的 NVLink 高速互联域。
相比于单台服务器,真正关键的是中间的第五代NVLink交换网络。9个NVLink Switch托盘将72张B300连接成一个非阻塞高速互联域,整柜NVLink聚合带宽达到130TB/s。NVIDIA官方规格同时给出了约20TB GPU显存、17TB CPU内存和2592个Arm Neoverse V2 CPU核心。
| 项目 | 单个计算托盘 | 整柜 NVL72 |
|---|---|---|
| 计算托盘 | 1U | 18个 |
| Grace CPU | 2颗 | 36颗 |
| CPU核心 | 2 × 72核 | 2592 CPU核心 |
| B300 GPU | 4张 | 72张 |
| GPU HBM3e显存 | 约1.15TB | 约20.7TB |
| CPU LPDDR5X内存 | 960GB | 约17.28TB |
这样做有什么好处?
1.让72张GPU真正“协同计算”。传统多节点GPU集群一旦跨服务器,就需要经过外部网络。NVL72则把大量GPU间通信留在NVLink Fabric内部。其目的并不是单纯增加GPU数量,而是减少GPU等待通信的时间,让更多GPU同时保持高利用率。
2. 更适合超大模型和MoE。当模型无法放进8张GPU时,就必须进行模型切分。NVL72提供一个72 GPU高速NVLink域,可以让张量并行、专家并行等通信密集型任务跨越更多GPU,同时保持很高的互联带宽。这对于数千亿参数模型、MoE以及推理型AI尤其重要。
3. 柜内Scale-up,柜间Scale-out。NVLink解决的是72张GPU柜内高速互联。当72张GPU仍然不够时,每个计算托盘还配置ConnectX-8高速网络,进一步通过800Gb/s InfiniBand或Spectrum-X网络连接多个NVL72机柜。
以下就是常见的配置清单:
**计算架构:**整柜配置18个1RU GB300计算托盘,每托盘搭载2个GB300 Grace Blackwell Ultra Superchip,由2颗NVIDIA Grace CPU及4颗NVIDIA Blackwell Ultra B300 GPU组成;整柜合计36颗Grace CPU、72颗B300 GPU。
**GPU显存:**单GPU配置288GB HBM3e,单计算托盘GPU显存约1.15TB,整柜GPU高速显存约20.7TB。
**CPU内存:**单Grace CPU约480GB LPDDR5X,单计算托盘约960GB,整柜约17TB。
**NVLink互联:**配置9个第五代NVLink Switch Tray,每托盘2颗NVSwitch,整柜共18颗NVSwitch,构建72 GPU全互联NVLink Domain;单GPU NVLink带宽最高约1.8TB/s,整柜NVLink聚合带宽约130TB/s。
**高速网络:**每计算托盘配置4×NVIDIA ConnectX-8 SuperNIC,支持最高800Gb/s高速计算网络;配置NVIDIA BlueField-3 DPU用于存储、管理及基础设施网络。
**本地存储:**每计算托盘支持E1.S PCIe 5.0 NVMe高速SSD,并配置M.2 NVMe系统盘。
**液冷:**整柜采用直接液冷架构,配置机柜级液冷Manifold及盲插液冷接口。
**供电:**整柜配置8×33kW Power Shelf,每Power Shelf配置6×5.5kW PSU,支持冗余供电;整柜最大设施功率需求约142kW。
当然,亮眼的不只是性能,还有价格!一整套机柜,目前国内报价大约在上亿元,租用价格一般在300万/月上下。(波动比较大,仅供参考)
最后,简单分析下为什么GB300比H100、H200更适合做token工厂。
一方面,GB300 NVL72则是一个为规模化Token生产而生的专用系统,它通过架构、内存、互联和软件的全栈优化,降低Token成本。根据国外机构测算,使用 Blackwell 架构的 GB300 NVL72 配置运行 DeepSeek-R1 时,每块 GPU 可生成 6,000 个 tokens,而 HGX H200 上仅能生成 90 个 tokens。Blackwell 每兆瓦可交付 280 万tokens——是 Hopper 的 50 倍以上。折算下来,每百万枚token成本仅为 0.12 美元,而 Hopper 的对应成本为 4.20 美元。
另一方面,可能H100、H200作为训练卡租用的收益比较好,也没有必要去抢做token工厂。H100单卡售价约20万、H200单卡约40万,单台8卡服务器的租金可能在一年多即可回本。
 京公网安备11010802029412号